Si vous avez parcouru les allées virtuelles des boutiques informatiques ces derniers mois, vous avez forcément remarqué une étrange épidémie. Des boîtiers pas plus gros qu’une boîte de mouchoirs affichent fièrement des autocollants « AI Ready », « Copilot+ » ou encore des scores de « 60 TOPS » en lettres brillantes. À en croire les fiches marketing, n’importe quel pavé en aluminium de quinze centimètres de côté serait désormais capable de rivaliser avec un centre de données de la Silicon Valley, le tout dans un silence de cathédrale et pour le prix d’un vélo électrique d’entrée de gamme.
Spoiler alert : c’est un peu plus subtil que cela. Si l’idée de faire tourner votre propre assistant intelligent à la maison, loin des regards indiscrets du cloud et sans payer d’abonnement mensuel, est devenue une réalité tout à fait accessible en cette fin d’année 2026, le chemin vers le Graal de l’IA locale est semé d’embûches marketing. Entre les chiffres gonflés aux stéroïdes, les mémoires bridées en douce et les processeurs mal compris, il est très facile de repartir avec une machine qui s’essouffle dès qu’on lui demande de résumer un PDF de trois pages.
Installez-vous confortablement, on sort la loupe pour démêler le vrai du faux, en répondant aux questions que tout le monde se pose avant de sortir la carte bleue.
Pourquoi un Mini PC bourré de TOPS rame-t-il sur un vrai modèle de langage ?
C’est la grande désillusion de nombreux acheteurs. Vous repérez une jolie machine toute neuve équipée d’un processeur dernier cri — disons un Intel Core Ultra Série 3 (« Panther Lake ») ou un AMD Ryzen AI 9 — affichant un NPU (Neural Processing Unit) à 50 ou 60 TOPS (trillions d’opérations par seconde). Vous la branchez, vous téléchargez un modèle de langage local respectable de 30 milliards de paramètres, vous tapez votre question… et le texte s’affiche à la vitesse d’un fax des années quatre-vingt-dix, mot par mot, comme si la machine réfléchissait au sens profond de l’existence.
Que s’est-il passé ? Vous venez de vous heurter au mur de la bande passante mémoire.
Pour le dire simplement, un NPU est un sprinter très doué pour les petites tâches répétitives et légères en arrière-plan : flouter votre arrière-plan lors d’une visioconférence, transcrire une note vocale ou trier vos photos. Mais dès que l’on attaque les grands modèles de langage (LLM), le processeur doit lire et relire des dizaines de gigaoctets de données à chaque mot généré. Dans ce scénario, la puissance brute de calcul passe au second plan : le véritable goulot d’étranglement, c’est la vitesse à laquelle la mémoire vive (la RAM) parvient à alimenter la puce graphique intégrée (l’iGPU).
Si vous avez une Formule 1 (le processeur), mais que vous l’alimentez avec un tuyau d’arrosage de jardin (une mémoire classique trop lente), votre bolide va toussoter. C’est précisément pour cette raison que les machines équipées de barrettes SO-DIMM standard (souvent limitées à 5 600 MT/s) peinent face aux architectures à mémoire unifiée soudée haute vitesse, capables de faire circuler les données à des débits astronomiques.
Faut-il se méfier des fiches techniques entre les salons et la mise en vente ?
Oh que oui, et l’actualité récente nous offre un cas d’école savoureux. Les salons technologiques sont un peu comme les bandes-annonces de cinéma : on vous montre les scènes les plus spectaculaires, quitte à couper quelques effets spéciaux au montage final.
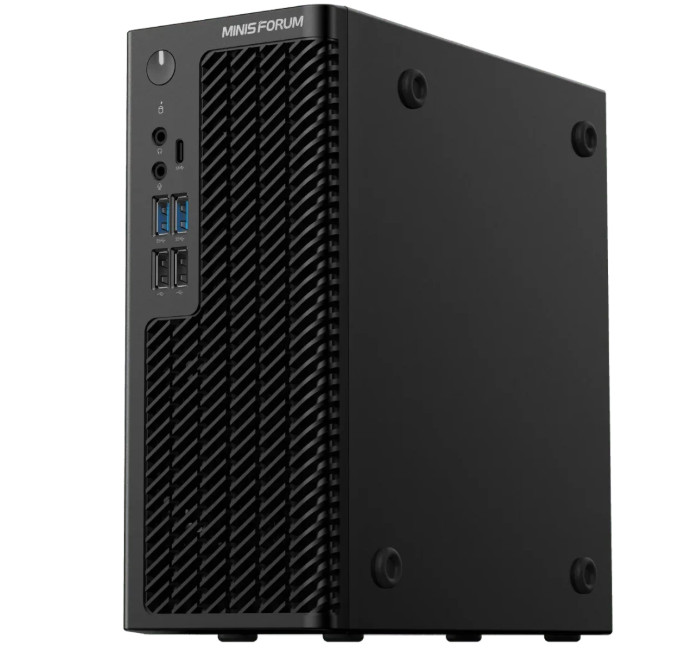
Prenez l’exemple du MINISFORUM T5 Max-388. Lors de sa présentation remarquée à l’IFA 2026, ce Mini PC basé sur la prometteuse architecture AMD Strix Halo (avec un processeur Ryzen AI Max+ 388) faisait rêver les amateurs d’IA locale grâce à une fiche technique annonçant de la mémoire LPDDR5X cadencée à 8 000 MT/s. Une bande passante idéale pour nourrir sa partie graphique intégrée. Sauf qu’au moment de sa mise en vente officielle, surprise : le constructeur a discrètement revu la copie. La machine est finalement livrée avec 48 Go de mémoire soudée en LPDDR5-6400.
Ce glissement de 8 000 à 6 400 MT/s n’est pas un simple détail cosmétique pour les puristes. En IA locale, une baisse de 20 % de la fréquence mémoire se traduit quasi mécaniquement par une baisse de 20 % du nombre de mots générés par seconde. Ajoutez à cela une petite astuce commerciale bien connue — afficher un prix de lancement de 1 559 dollars présenté comme une « promotion » face à un tarif normal fictif de 1 949 dollars — et vous comprenez pourquoi il faut toujours vérifier les spécifications définitives le jour de la commercialisation plutôt que de se fier aux promesses des salons.
Cela dit, même avec cette mémoire revue à la baisse, ce T5 Max-388 conserve un atout majeur : ses 48 Go de RAM unifiée. Là où un PC classique plafonne souvent à 32 Go (dont seule une petite partie est accessible à la puce graphique), ces 48 Go permettent de charger en mémoire des modèles intermédiaires (autour de 24B à 32B paramètres) sans que le système ne s’effondre.
Quelle est la vraie différence entre la RAM soudée et les barrettes amovibles ?
Pendant des années, les passionnés d’informatique ont voué aux gémonies la mémoire soudée, synonyme d’obsolescence programmée et d’impossibilité de faire évoluer sa machine. L’ironie de l’ère de l’intelligence artificielle, c’est que cette même mémoire soudée est devenue notre meilleure alliée.
Pour atteindre des débits vertigineux sur un bus très large (souvent 256 bits sur les puces haut de gamme actuelles), les ingénieurs doivent coller les puces de mémoire au plus près du processeur. Les connecteurs amovibles classiques créent trop de latence et limitent les fréquences. Par conséquent, si vous visez l’IA locale sérieuse, il faut faire le deuil de l’évolutivité et choisir la bonne capacité dès l’achat.
Heureusement, les constructeurs ont compris le message et proposent désormais des configurations musclées :
- L’école de la démesure compacte : Des modèles comme l’ACEMAGIC F9A (animé par un processeur Ryzen AI Max+ PRO 495) ou le GMKtec EVO-X2 (doté du Ryzen AI Max+ 395) poussent le concept très loin en proposant des déclinaisons embarquant 128 Go, voire 192 Go de mémoire unifiée très rapide. Dans un boîtier qui tient sur un coin de bureau, vous pouvez ainsi faire tourner des mastodontes comme DeepSeek-R1 en version 70 milliards de paramètres, un exploit qui demandait encore récemment une tour de trente kilos équipée de deux cartes graphiques professionnelles.


- L’école de l’efficacité polyvalente : Si vos besoins sont plus raisonnables (génération de texte courante, aide au code, petits agents autonomes), les nouveaux Mini PC sous architecture Intel Panther Lake, à l’image du MINISFORUM M2 Pro (Core Ultra X7 358H) ou du MINIX EU736-AI, misent sur une consommation énergétique très contenue et une partie graphique intégrée Xe3 nettement plus agile que par le passé.
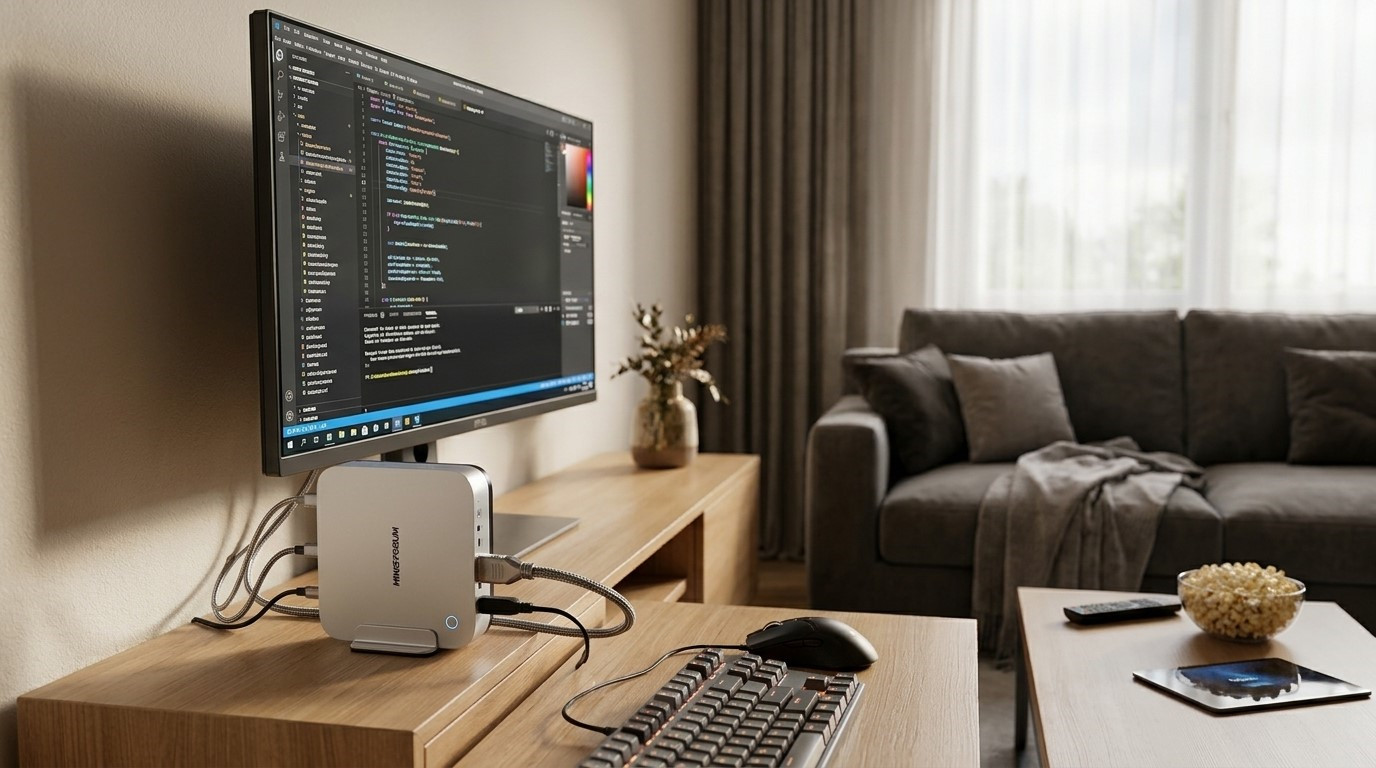
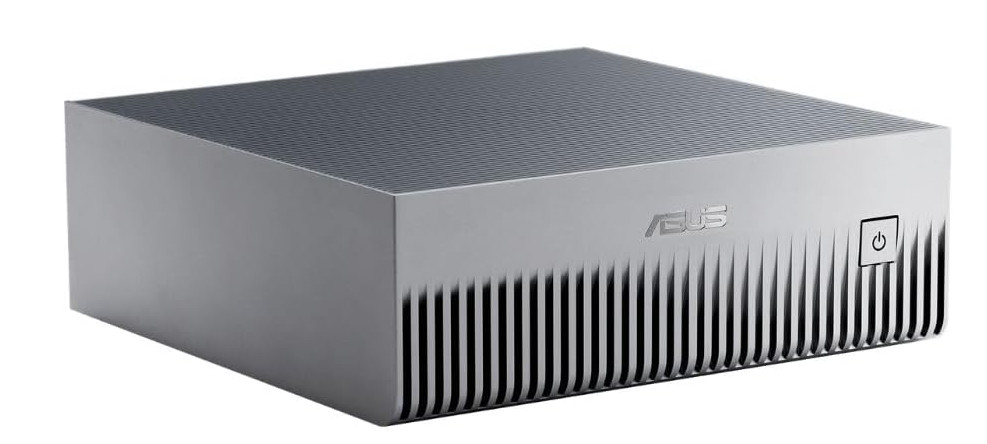
Minisforum M2 Pro-358H - L’école de la force brute spécialisée : Pour les développeurs qui ne jurent que par l’écosystème CUDA de NVIDIA, des mini-stations comme l’ASUS Ascent GX10 (bâti autour de la puce GB10 avec 128 Go de mémoire unifiée) jouent dans une autre cour tarifaire (autour de 3 000 dollars), mais offrent une compatibilité logicielle immédiate avec tous les outils d’entraînement et d’inférence du marché.
Comment éviter l’effet « sèche-cheveux » sur son bureau ?
Il existe un dernier paramètre que les fiches techniques oublient systématiquement de mentionner en gros caractères : l’acoustique. Faire tourner un modèle de langage n’a rien d’une promenade de santé pour le silicium. Contrairement à un jeu vidéo où la charge varie d’une scène à l’autre, l’inférence IA sollicite le processeur graphique et la mémoire à 100 % de leurs capacités, de manière continue.
Dans un châssis minuscule de un ou deux litres, dissiper 80 à 120 watts en continu relève du défi thermodynamique. Certains Mini PC ultra-compacts se transforment alors en soufflerie d’avion au décollage dès que vous lancez une requête un peu longue. Avant de valider votre panier, jetez un œil à la taille du boîtier et aux tests thermiques : un châssis légèrement plus généreux (autour de 4 à 6 litres, comme certains modèles orientés station de travail) abrite généralement des ventilateurs plus grands, qui tournent moins vite et préservent vos tympans ainsi que la longévité des composants.
La checklist rapide avant de passer à la caisse
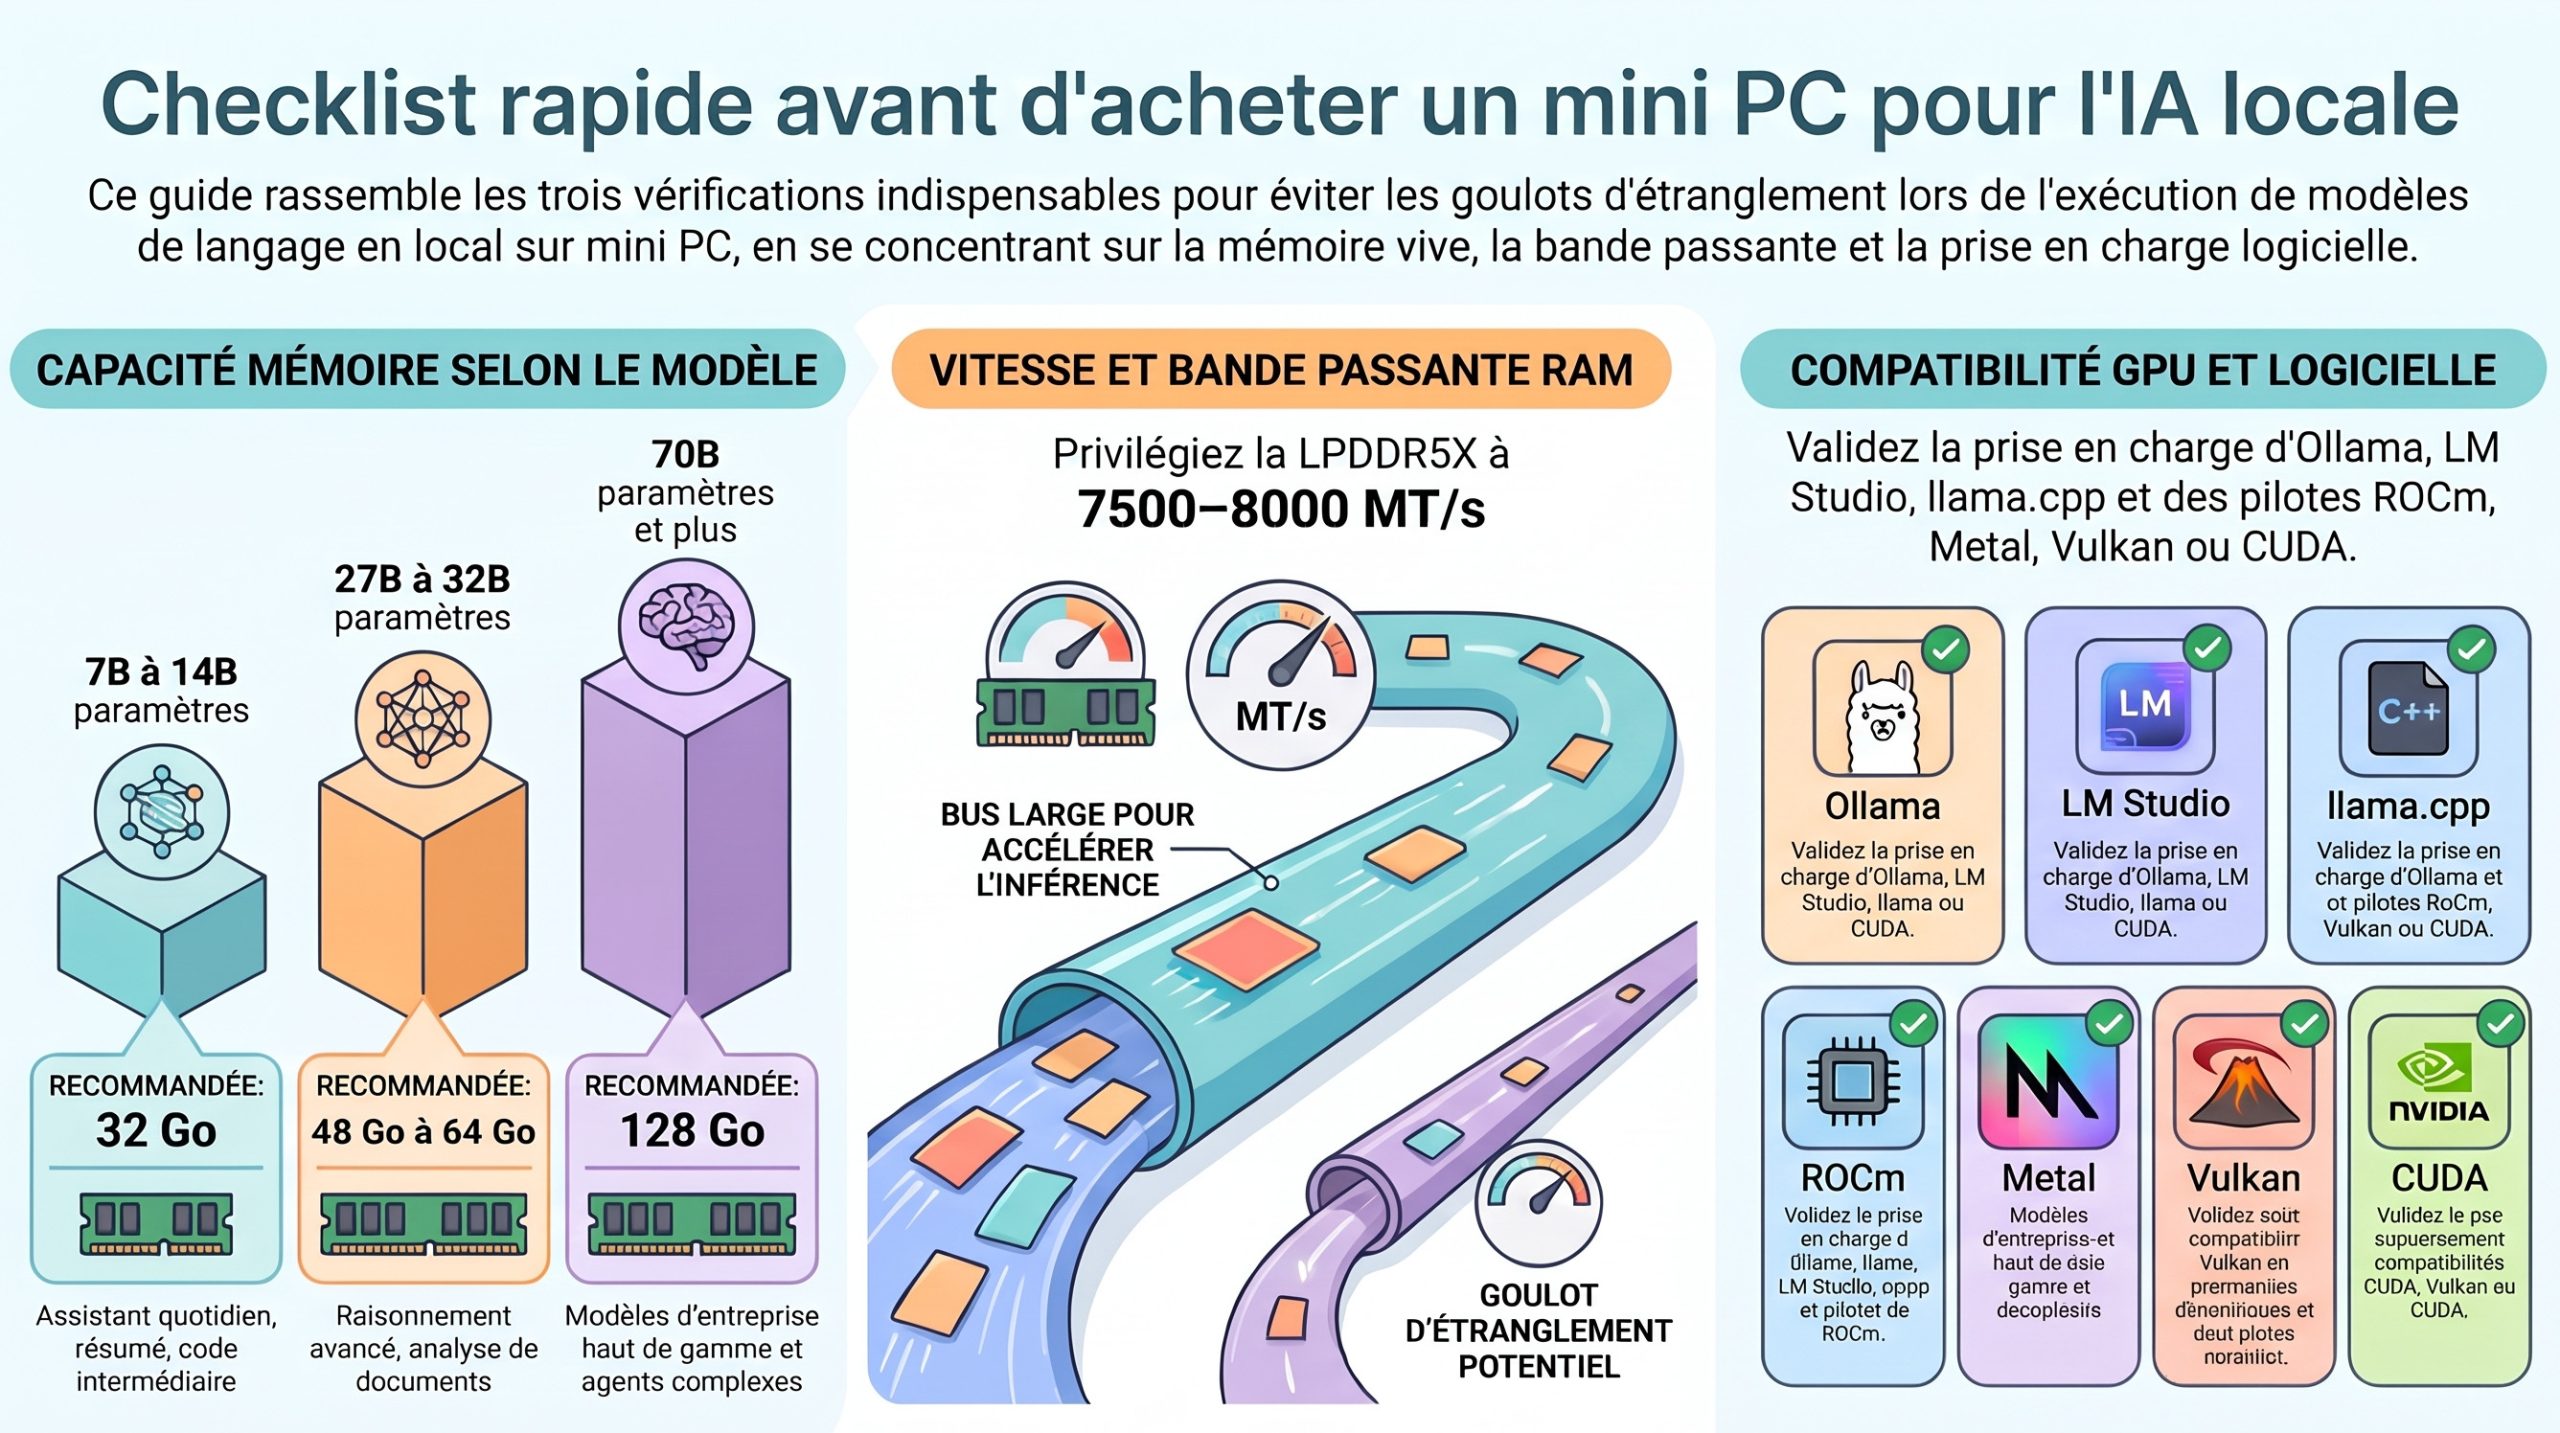
Pour résumer, ne vous laissez plus hypnotiser par le nombre de TOPS affiché sur la boîte. Si vous cherchez un Mini PC pour dompter l’IA en local sans mauvaises surprises, gardez ces trois réflexes en tête :
- Regardez la capacité mémoire avant le processeur : 32 Go est le strict minimum vital pour s’amuser avec de petits modèles (7B à 14B) ; 48 Go à 64 Go ouvre les portes des modèles sérieux (32B) ; 128 Go vous propulse dans la cour des grands (70B).
- Vérifiez la vitesse réelle de la RAM : Privilégiez la LPDDR5X à 7 500 ou 8 000 MT/s sur bus large, et méfiez-vous des révisions silencieuses à la baisse entre l’annonce et la livraison.
- Choisissez votre camp logiciel : Assurez-vous que la puce graphique choisie est bien supportée par les outils que vous comptez utiliser (Ollama, LM Studio, llama.cpp), car le matériel le plus rapide du monde ne vaut rien sans de bons pilotes.