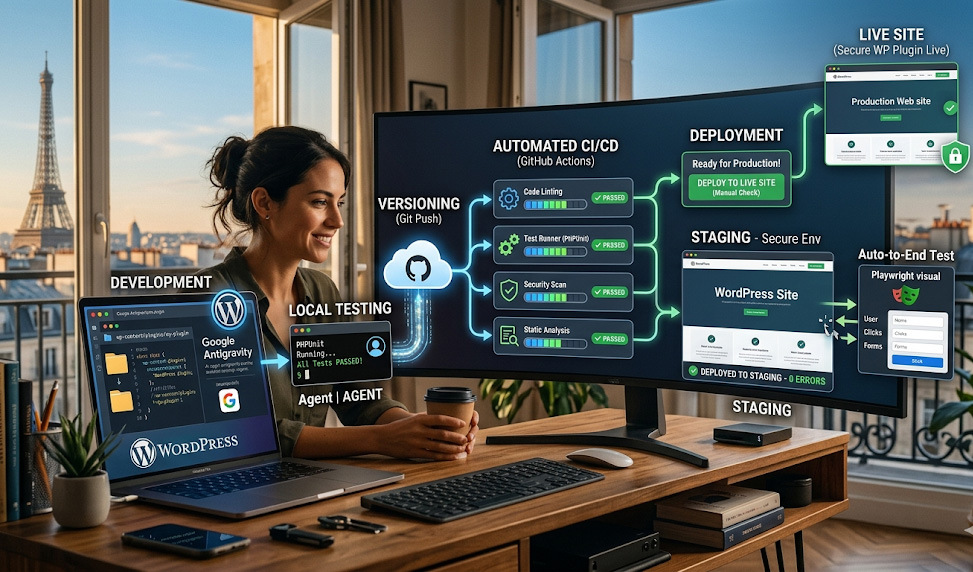
Le quotidien de l’ingénieur DevOps moderne est trop souvent captif du « Toil » : ce travail opérationnel répétitif, manuel et dépourvu de valeur durable qui sclérose l’innovation.
L’IDE Antigravity et le Model Context Protocol (MCP) révolutionnent le DevOps en remplaçant les tâches manuelles par des pipelines autonomes gérés par l’IA. Cette approche repose sur plusieurs piliers :
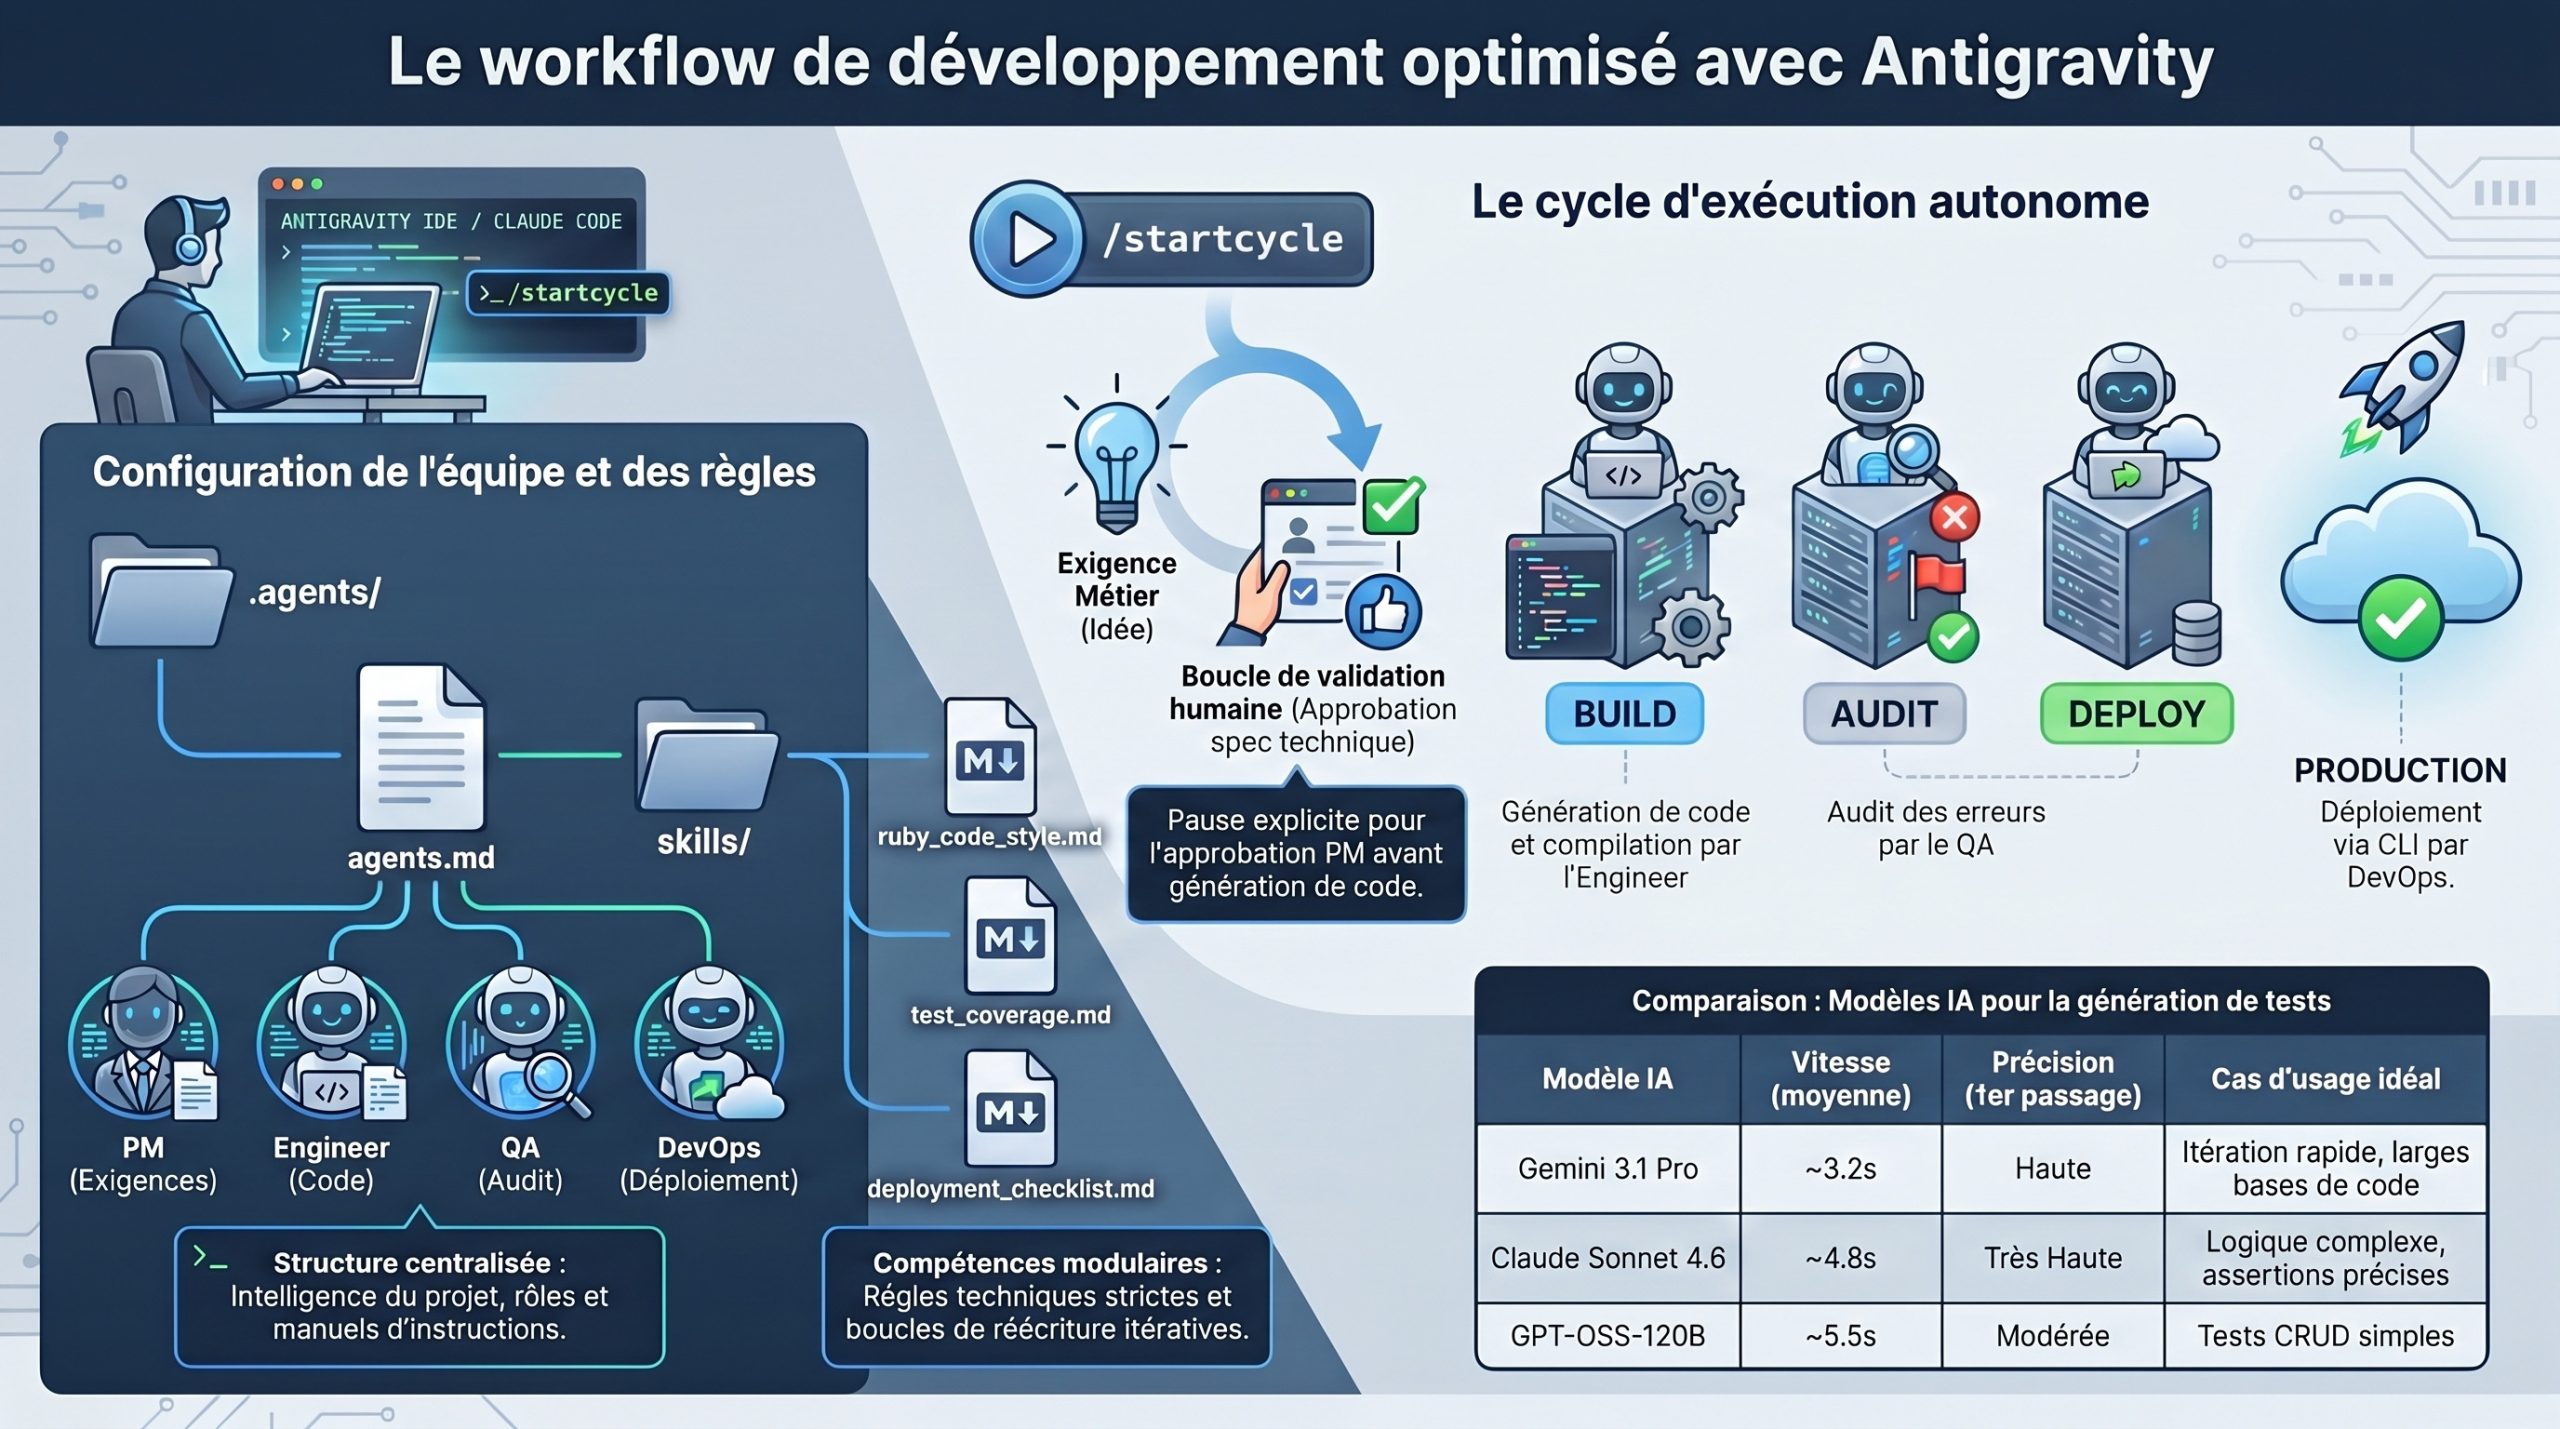
- Orchestration multi-agents : Création d’une « Dream Team » IA où chaque agent (Product Manager, Ingénieur, QA, DevOps) possède un rôle et des contraintes stricts pour éviter les erreurs.
- Tests automatisés intelligents : Grâce au MCP, les agents s’interfacent avec des outils comme Playwright (tests d’interface sémantiques) et PHPUnit pour valider le code avec précision.
- Déploiements résilients : Le processus intègre des validations humaines obligatoires, des rollbacks automatiques instantanés en cas d’alerte de monitoring, et le découplage des migrations de base de données (via Atlas) pour éviter les pannes.
- Évaluation des performances : L’efficacité du système se mesure objectivement via les métriques DORA (fréquence de déploiement, MTTR).
L’ingénieur DevOps passe ainsi d’un rôle d’exécuteur technique à celui de superviseur de systèmes autonomes.
Entre la maintenance de scripts YAML labyrinthiques, le triage épuisant des tests instables (flaky tests) et la surveillance anxieuse des déploiements, la promesse de l’automatisation semble parfois se noyer sous une complexité croissante.
Pourtant, une rupture paradigmatique s’opère. Imaginez une « Dream Team » d’agents d’intelligence artificielle gérant l’intégralité du cycle de vie de vos applications : de la spécification technique à l’écriture du code, jusqu’à la validation QA et l’orchestration des rollbacks en production, le tout sans intervention humaine constante. Est-il possible de transformer ce processus « lourd » en un flux de travail fluide et auto-géré grâce à une orchestration « Zero-Code » ? C’est ce que permet aujourd’hui l’IDE Antigravity, propulsé par le Model Context Protocol (MCP).
Définir votre « Dream Team » IA avec agents.md
L’erreur la plus commune dans l’intégration de l’IA est de traiter le modèle comme un monolithe omniscient. En demandant à une IA de concevoir l’architecture, de coder et de tester simultanément, on s’expose à une confusion cognitive majeure du modèle, menant inévitablement à des hallucinations. La solution réside dans la séparation stricte des personas via le fichier .agents/agents.md.
Antigravity utilise ce fichier pour centraliser les identités de votre équipe IA. Comme le souligne la documentation : « Lorsqu’on demande à une IA de construire une application entière, elle peut facilement être dépassée. La centralisation des rôles prévient cette confusion. » En segmentant les contextes, chaque agent dispose d’une fenêtre d’attention optimisée pour sa tâche.
Voici la structure de cette équipe spécialisée :
- Le Product Manager (@pm) : Le gardien de la vision. Il se concentre sur les objectifs business et rédige les fichiers
Technical_Specification.md. Il ne code jamais, mais orchestre les boucles de validation avec l’utilisateur. - Le Full-Stack Engineer (@engineer) : L’exécuteur technique. Sa mission est de transformer les spécifications approuvées en code de production, sans se soucier de la planification initiale.
- Le QA Engineer (@qa) : Le censeur. Son regard est critique ; il traque les régressions, les erreurs de syntaxe et les dépendances manquantes que l’ingénieur aurait pu omettre.
- Le DevOps Master (@devops) : L’architecte du runtime. Il maîtrise le terminal, gère les environnements de déploiement et configure l’infrastructure nécessaire au fonctionnement de l’application.
Chaque persona est défini par trois piliers :
- Goals (Objectifs) : La responsabilité finale dans le pipeline.
- Traits (Personnalité) : Le comportement attendu (ex: « paranoïaque sur la sécurité »).
- Constraints (Contraintes) : Les limites strictes pour éviter les dérives (ex: « @pm ne doit jamais modifier les fichiers .js »).
Le protocole MCP : Doter vos agents d’une conscience contextuelle
Pour qu’un agent soit réellement efficace, il doit cesser de « deviner » l’état de votre application. Le Model Context Protocol (MCP) agit comme les « yeux » et le « corps » de vos agents, leur permettant d’interagir avec des outils externes de manière structurée.
L’intégration de Playwright via MCP révolutionne le test automatisé. Contrairement aux approches classiques basées sur des captures d’écran ou des sélecteurs CSS fragiles, le serveur MCP permet aux agents d’Antigravity d’accéder à l’arbre d’accessibilité (accessibility tree) de la page. Cette méthode est supérieure car elle utilise des locateurs sémantiques comme getByRole ou getByTestId, qui restent stables même si le design visuel de l’application évolue.
Configuration du serveur MCP Playwright
Pour activer cette puissance, vous devez configurer le fichier mcp-config.json dans Antigravity :
{
  "mcpServers": {
    "playwright": {
      "command": "npx",
      "args": ["-y", "@playwright/mcp"]
    }
  }
}
Le « Rework Loop » et les Skills
Les compétences de vos agents sont définies dans .agents/skills/. Un aspect crucial est la gestion du feedback humain. Dans le fichier .agents/skills/write_specs.md, nous implémentons une logique de boucle de retravail (Rework Loop). L’agent est explicitement instruit de :
- Générer l’artefact.
- S’arrêter et attendre que l’utilisateur lise le fichier Markdown.
- Détecter toute modification ou commentaire inline laissé par l’humain dans l’IDE.
- Réviser son travail jusqu’à l’obtention d’un signal d’approbation explicite.
Pour maximiser la stabilité, vous pouvez importer des bibliothèques de compétences éprouvées, comme celles proposées par TestDino : npx skills add https://github.com/testdino/playwright-skills --skill core
Enfin, pour assurer une cohérence d’équipe, le fichier .antigravity/rules.md doit imposer des standards stricts, par exemple : « Toujours utiliser le Page Object Model (POM) et interdire les waitForTimeout au profit de l’auto-waiting de Playwright. »
Automatisation PHP et PHPUnit : Le générateur de serveur MCP
Le monde PHP n’est pas en reste dans cette révolution agentique. L’outil php-mcp-server-generator permet de créer des serveurs MCP robustes, facilitant l’accès de vos agents à vos environnements PHP.
Ce générateur utilise l’architecture moderne de PHP 8.2+ et s’appuie sur le SDK officiel. Une caractéristique technique majeure est l’utilisation des Attributs PHP (#[McpTool], #[McpResource]) pour définir les capacités de l’agent. Cela permet une validation de schéma automatique via l’attribut #[Schema], garantissant que les paramètres envoyés par l’IA respectent scrupuleusement les types attendus.
npx skills add https://github.com/github/awesome-copilot --skill php-mcp-server-generator
Chaque « outil » (tool) généré par ce serveur inclut nativement des tests PHPUnit. Dans une optique de fiabilité, l’agent @qa doit systématiquement exécuter ces tests pour valider que les nouveaux outils créés respectent les standards PSR-12 et ne cassent pas la logique métier existante. C’est le principe du « Zero-Code orchestration » : l’IA construit ses propres outils, mais sous la surveillance d’un cadre de test rigoureux.
Sécuriser le pipeline : Approbations et auto-guérison
L’autonomie totale ne doit pas sacrifier la sécurité. Pour les déploiements critiques, l’utilisation des Environments de GitHub Actions est indispensable. Ils permettent d’instaurer des « Required Reviewers », créant une barrière d’approbation manuelle obligatoire avant toute mise en production.
La stratégie de rollback « Alert-driven »
Une architecture visionnaire doit prévoir l’échec. En couplant un service de monitoring (Papertrail, New Relic) à un webhook FastAPI, vous pouvez automatiser la résilience. Lorsqu’un seuil critique est atteint (par exemple, un taux d’erreur > 5%), le webhook reçoit une alerte JSON et déclenche immédiatement un événement repository_dispatch vers GitHub.
Ce déclencheur lance un workflow de rollback qui identifie la version stable précédente via l’API Heroku ou GitHub et rétablit le service en quelques minutes, là où une intervention humaine prendrait des heures.
| Caractéristique | Rollback Manuel (UI GitHub) | Rollback Automatique (Alert-driven) |
| Vitesse d’exécution | Dépend de la présence humaine | Quasi instantané (< 1 min) |
| Précision | Sujet à l’erreur humaine | Basé sur des seuils techniques (ex: >5% d’erreurs) |
| Complexité | Faible | Modérée (nécessite un webhook FastAPI) |
| Impact DORA | Augmente le MTTR | Réduit drastiquement le MTTR |
La fin des migrations SQL au démarrage : L’approche Atlas et Codefresh
Le pattern traditionnel consistant à exécuter les migrations de base de données au démarrage du conteneur (startup migrations) est une dette technique majeure dans l’ère Kubernetes. En environnement distribué, si plusieurs réplicas tentent de migrer la même base simultanément, vous créez des verrous (locks) et des conflits.
Pire encore, comme le souligne le blog Octopus : « En liant la migration au démarrage, vous vous retrouvez avec des conteneurs qui échouent complètement et cessent de servir du trafic en cas de problème de migration, causant un downtime inutile. » Dans un cluster, le scheduler Kubernetes peut relancer les pods à tout moment, et forcer une migration à chaque démarrage entraîne une pénalité de performance de type O(n) par rapport au nombre de conteneurs.
La solution est de découpler le cycle de vie de la donnée via Atlas et Codefresh.
- Linting de migration : Le pipeline lance une base de données temporaire (via les « Service Containers » de Codefresh). Atlas utilise ce « Dev-URL » pour tester le code SQL avant de toucher à la production.
- Détection préventive : Atlas détecte les changements destructeurs ou les erreurs de syntaxe à cette étape.
- Visibilité totale : Via Atlas Cloud, vous obtenez une vue graphique de l’évolution de votre schéma, permettant de visualiser chaque changement (changeset) de manière chronologique.
Mesurer le succès avec les métriques DORA
L’efficacité de votre transformation vers des pipelines autonomes ne se décrète pas, elle se mesure via les 5 métriques DORA (DevOps Research and Assessment) :
- Fréquence de déploiement : La cadence à laquelle vous livrez de la valeur en production.
- Délai de mise en production (Lead Time) : Le temps entre le commit et le déploiement final.
- Délai de rétablissement (MTTR) : La vitesse à laquelle vous réparez un échec (optimisé ici par nos rollbacks automatiques).
- Taux d’échec des changements : Le pourcentage de déploiements causant un incident.
- Taux de déploiements non planifiés : La proportion de correctifs d’urgence nécessaires.
Il existe un lien organique entre ces métriques : un taux élevé de déploiements non planifiés impacte négativement votre MTTR en surchargeant vos équipes. L’automatisation par agents vise à stabiliser le taux d’échec par un audit constant, tout en compressant le Lead Time par l’élimination des tâches manuelles de « Toil ».
Vers une autonomie totale mais surveillée
La combinaison d’Antigravity, du protocole MCP et de solutions comme TestDino redéfinit fondamentalement la mission du DevOps. Vous ne passez plus votre temps à trier des tests instables ou à corriger manuellement des migrations SQL ratées. Vous passez d’un rôle d’exécuteur manuel à celui d’orchestrateur de systèmes autonomes.
Cette transition permet un gain de productivité estimé entre 15 et 20 % rien que sur la gestion des tests. En déléguant les cycles de « fix-and-retry » à des agents capables de naviguer réellement dans l’application et de s’auto-corriger, vous libérez votre temps pour des missions à plus haute valeur ajoutée : l’architecture de systèmes résilients et la stratégie d’innovation.
La question pour le futur des équipes DevOps n’est plus « Comment automatiser ? », mais « Comment superviser l’autonomie ? ». Si vos agents peuvent coder, tester et réparer eux-mêmes vos pipelines, quelle sera votre prochaine grande mission technique ?