Le paysage de l’intelligence artificielle générative est actuellement dominé par une dépendance quasi-totale aux infrastructures centralisées. Pour les ingénieurs, cette réalité se traduit par un paradoxe technique : travailler sur des modèles de pointe via des instances cloud soumises à une latence réseau imprévisible, ou subir le bruit et la consommation thermique de serveurs rackés en salle blanche.
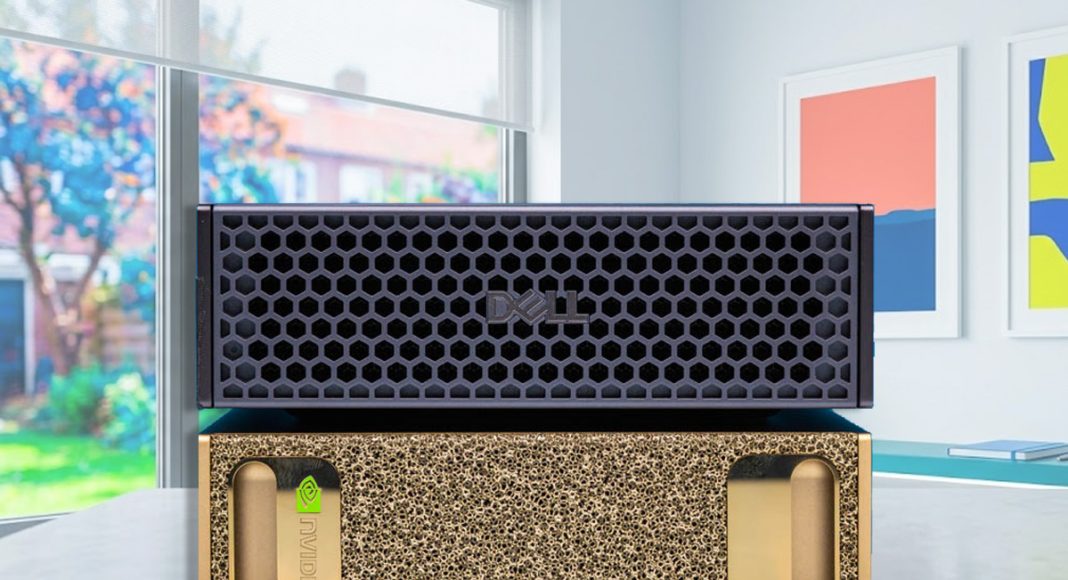
L’arrivée du Dell Pro Max avec puce NVIDIA Grace Blackwell (GB10), pilier de la nouvelle Dell AI Factory, marque un tournant. Ce n’est pas un énième ordinateur compact, mais une infrastructure de périphérie souveraine (Edge Sovereign Infrastructure). La question pour nous, architectes, n’est plus de savoir si l’on peut miniaturiser la puissance, mais comment Dell a réussi à intégrer l’équivalent d’un cluster de calcul dans un volume de 1,1 litre sans compromettre l’intégrité thermique.
Densité de calcul et efficacité thermique : 1 000 TOPS dans 15 centimètres
D’un point de vue purement matériel, le facteur de forme du Dell Pro Max GB10 défie les conventions du calcul haute performance (HPC). Avec des dimensions de 150 x 150 x 51 mm, l’appareil affiche une densité de calcul massive. Nous parlons de 1 000 TOPS en précision FP4, soit un pétaFLOP de puissance brute.
Contrairement aux stations de travail traditionnelles ou aux serveurs rackés qui exigent des circuits électriques dédiés (souvent du 208V/30A), cette unité opère sur une enveloppe thermique et électrique contenue. Son alimentation de 280 Watts permet un branchement sur une prise murale standard, tout en fournissant une performance qui nécessitait auparavant plusieurs serveurs 2U. Comme le souligne le constructeur :
« La puissance d’un datacenter dans un format desktop. »
La gestion thermique est ici exemplaire : le système maintient sa stabilité dans une plage de 0 °C à 35 °C. Cette résilience, couplée à un poids de 1,22 kg, permet un déploiement dans des environnements non climatisés, là où une infrastructure rack classique échouerait par surchauffe ou manque d’infrastructure électrique adaptée.

L’architecture Grace Blackwell : Une synergie CPU-GPU sans précédent
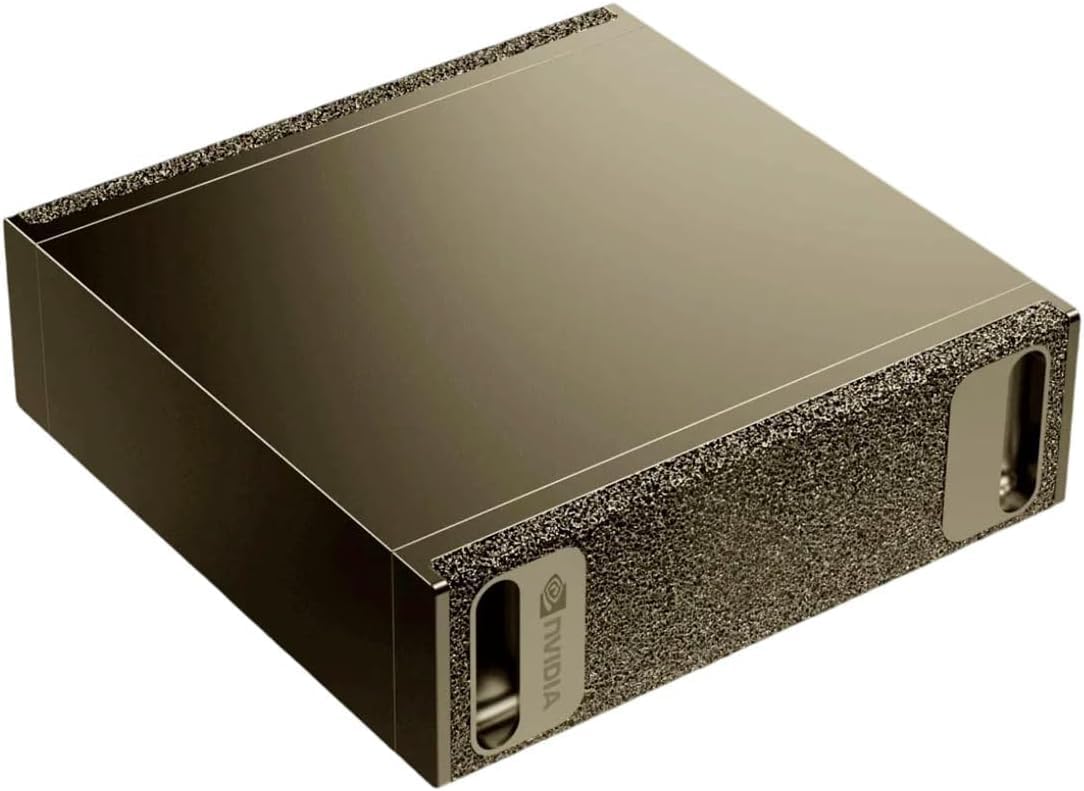
Le cœur de ce système réside dans la Superchip NVIDIA GB10 Grace Blackwell. Pour comprendre la rupture, il faut dissocier les rôles au sein de la puce. Le côté Grace s’appuie sur des cœurs Cortex-A725 et Cortex-X925 (architecture ARM), agissant comme un hôte à haute efficacité énergétique. Le côté Blackwell, lui, assure la charge de calcul massive dédiée aux tenseurs.
Le bus NVLink-C2C : Adieu les goulots PCIe
Le véritable tour de force est l’implémentation du NVLink-C2C (Chip-to-Chip). Dans une architecture standard, le transit des données entre CPU et GPU via le bus PCIe crée une latence critique. Ici, l’interface C2C offre une bande passante bidirectionnelle ultra-rapide, permettant un partage de données fluide et une latence quasi nulle.
Pipeline de données et mémoire unifiée
Attention à ne pas confondre les versions : alors que les catalogues grand public ou e-commerce affichent des modèles d’entrée de gamme limités à 32 Go de RAM, cette déclinaison IA Factory intègre 128 Go de mémoire unifiée LPDDR5x (soudée et partagée) à une vitesse effective de 8533 MT/s. Cette architecture haut de gamme est exclusivement accessible sur devis via les réseaux de distribution professionnels et les intégrateurs HPC.
Dans le flux de travail d’un développeur IA, la « famine de données » (data starvation) est le principal obstacle. Dell résout ce problème en alignant cette mémoire ultra-rapide avec un SSD NVMe QLC de 2 To sur interface PCI Express 4.0. Ce pipeline cohérent permet de charger des poids de modèles massifs depuis le stockage vers la mémoire vive avec une efficacité qui minimise les cycles d’attente du GPU.
Capacité d’inférence locale : La souveraineté au service de Llama 3.3
La possibilité d’exécuter localement des charges de travail complexes transforme radicalement la productivité. Prenons le cas d’usage de Llama 3.3 70B. Avec 128 Go de mémoire unifiée, le modèle s’intègre parfaitement avec son KV Cache en quantification FP4. Sur ce nœud d’IA de bureau, l’inférence ne dépend plus d’une connexion internet. Si l’on souhaite pousser jusqu’à des architectures de 200 milliards de paramètres, le couplage en cluster (Dual) devient indispensable pour éviter la saturation de la mémoire vive.
Pour les secteurs sensibles — défense, santé ou finance — l’avantage est triple :
- Souveraineté des données : Les données propriétaires et les prompts ne quittent jamais le périmètre physique de l’entreprise.
- Zéro coût d’egress : Le rapatriement de résultats ou de modèles affinés (fine-tuning) depuis le cloud engendre souvent des frais cachés massifs. Ici, le coût est nul.
- Prototypage itératif : La réduction des cycles de développement est brutale, passant de plusieurs mois de configuration cloud à quelques jours de validation locale.
NVIDIA DGX OS 7 : La pile logicielle « Datacenter-Ready »
Le Dell Pro Max GB10 ne doit pas être confondu avec un PC bureautique sous Windows. Il est livré avec NVIDIA DGX OS 7, une distribution basée sur Ubuntu Linux optimisée pour le HPC. En tant qu’architecte, c’est ce point qui valide le sérieux de la machine : elle est livrée avec une pile logicielle prête pour la production.
Les outils préinstallés incluent :
- NVIDIA CUDA pour l’accélération matérielle native.
- TensorRT pour l’optimisation de l’inférence.
- AI Workbench et PyTorch, permettant aux équipes de déployer leurs conteneurs en quelques minutes après le déballage.
C’est cette approche « clé en main » qui permet à de petites structures d’accéder à des capacités de niveau entreprise sans posséder d’armée d’administrateurs systèmes.
Scalabilité horizontale via ConnectX-7 et RDMA
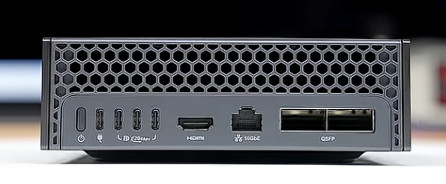
L’innovation la plus audacieuse de Dell pour ce format micro est sa capacité de mise en cluster. Grâce à l’intégration d’une carte Mellanox ConnectX-7 SmartNIC, l’appareil dispose de ports 200 GbE (QSFP).
Ce n’est pas une simple interface réseau, c’est un canal de scalabilité horizontale. En utilisant les technologies RDMA (Remote Direct Memory Access) et GPUDirect, deux unités Dell Pro Max peuvent être couplées pour former un nœud de calcul unique. Cette liaison permet à un processeur d’accéder directement à la mémoire de l’autre unité sans passer par la pile logicielle du CPU, minimisant ainsi la latence inter-nœuds.
| Configuration | Unité Solo (Pro B2B) | Cluster Dual (RDMA) |
| Mémoire Unifiée | 128 Go LPDDR5x | 256 Go LPDDR5x |
| Puissance de Calcul | 1 000 TOPS (FP4) | 2 000 TOPS (FP4) |
| Inférence (Modèles cibles) | Jusqu’à 70B (ex: Llama 3.3) | Jusqu’à 200 Milliards + |
Connectivité et Sécurité : Une forteresse en périphérie
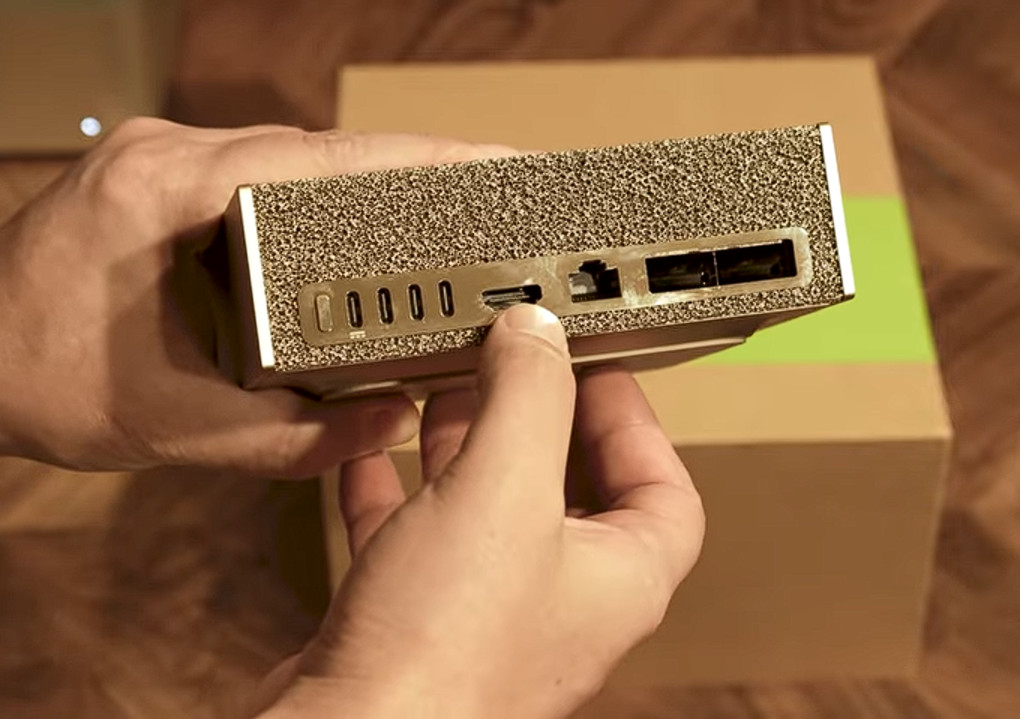
Pour les déploiements en mode Edge Computing, la connectivité est exhaustive : Wi-Fi 7, Bluetooth et un port 10GbE RJ-45 complètent les interfaces 200GbE. Cependant, c’est sur la sécurité matérielle que Dell insiste avec l’intégration d’une puce TPM 2.0 (Trusted Platform Module).
Dans un contexte de « calcul à la source », la sécurité physique et cryptographique est impérative. Le TPM 2.0 garantit l’intégrité du boot et la protection des clés de chiffrement locales. Pour une équipe travaillant sur de l’analytique sécurisée en périphérie, cette combinaison de puissance et de sécurité transforme le Dell Pro Max en un coffre-fort de données actives.
ROI et investissement stratégique
Le ticket d’entrée de cette déclinaison IA Factory, bien que nettement supérieur aux tarifs des stations de travail classiques en raison de l’intégration de l’architecture Blackwell et de la suite logicielle dédiée, représente un investissement stratégique majeur pour les équipes de R&D.
Si l’on compare le coût d’acquisition de ce nœud souverain aux abonnements cumulés des instances GPU haut de gamme sur le cloud, le seuil de rentabilité est atteint rapidement pour une équipe de développement active. Le calcul doit intégrer non seulement le coût matériel, mais surtout l’absence totale de frais d’egress pour les To de données de training et de validation. Le gain de productivité lié à l’absence de files d’attente pour les ressources de calcul partagées est inestimable. Comme le précise la documentation :
« Votre propre Cloud IA privé : aucun conflit pour le calcul du datacenter ou dépense liée aux instances Cloud. »
Vers une IA distribuée et performante
Le Dell Pro Max avec puce GB10 n’est pas qu’une prouesse de miniaturisation ; c’est un changement de paradigme pour l’infrastructure d’entreprise. En offrant une alternative locale, souveraine et scalable aux serveurs rackés et au cloud, Dell permet une démocratisation réelle du calcul intensif.
Le futur de l’intelligence artificielle ne sera probablement pas uniquement centralisé dans des datacenters géants. Il s’appuiera sur une constellation de ces nœuds d’IA de bureau, capables de traiter des architectures massives sur un coin de table. Pour l’architecte moderne, la question n’est plus « combien de racks ? », mais « combien de nœuds Dell Pro Max ? » pour soutenir l’innovation. Une chose est certaine : avec le GB10, la puissance ne se mesure plus au mètre linéaire, mais à l’efficacité du pipeline de données local.